Первый раздел объясняет суть без вступления и рекламных обещаний.
Рабочие настройки сохраняют до изменения, а проверку проводят на копии.
Запишите исходное состояние, действие и итог, чтобы найти причину ошибки.
На VPS работают приложение, очередь и база; GPU не нужен.
Локальной модели нужна RAM или VRAM под веса и контекст.
Требует больше памяти, чем запуск готовой модели.
Диск, сеть и остановленные ресурсы считают вместе с GPU.
Источники: Ollama GPU support, Ollama FAQ.
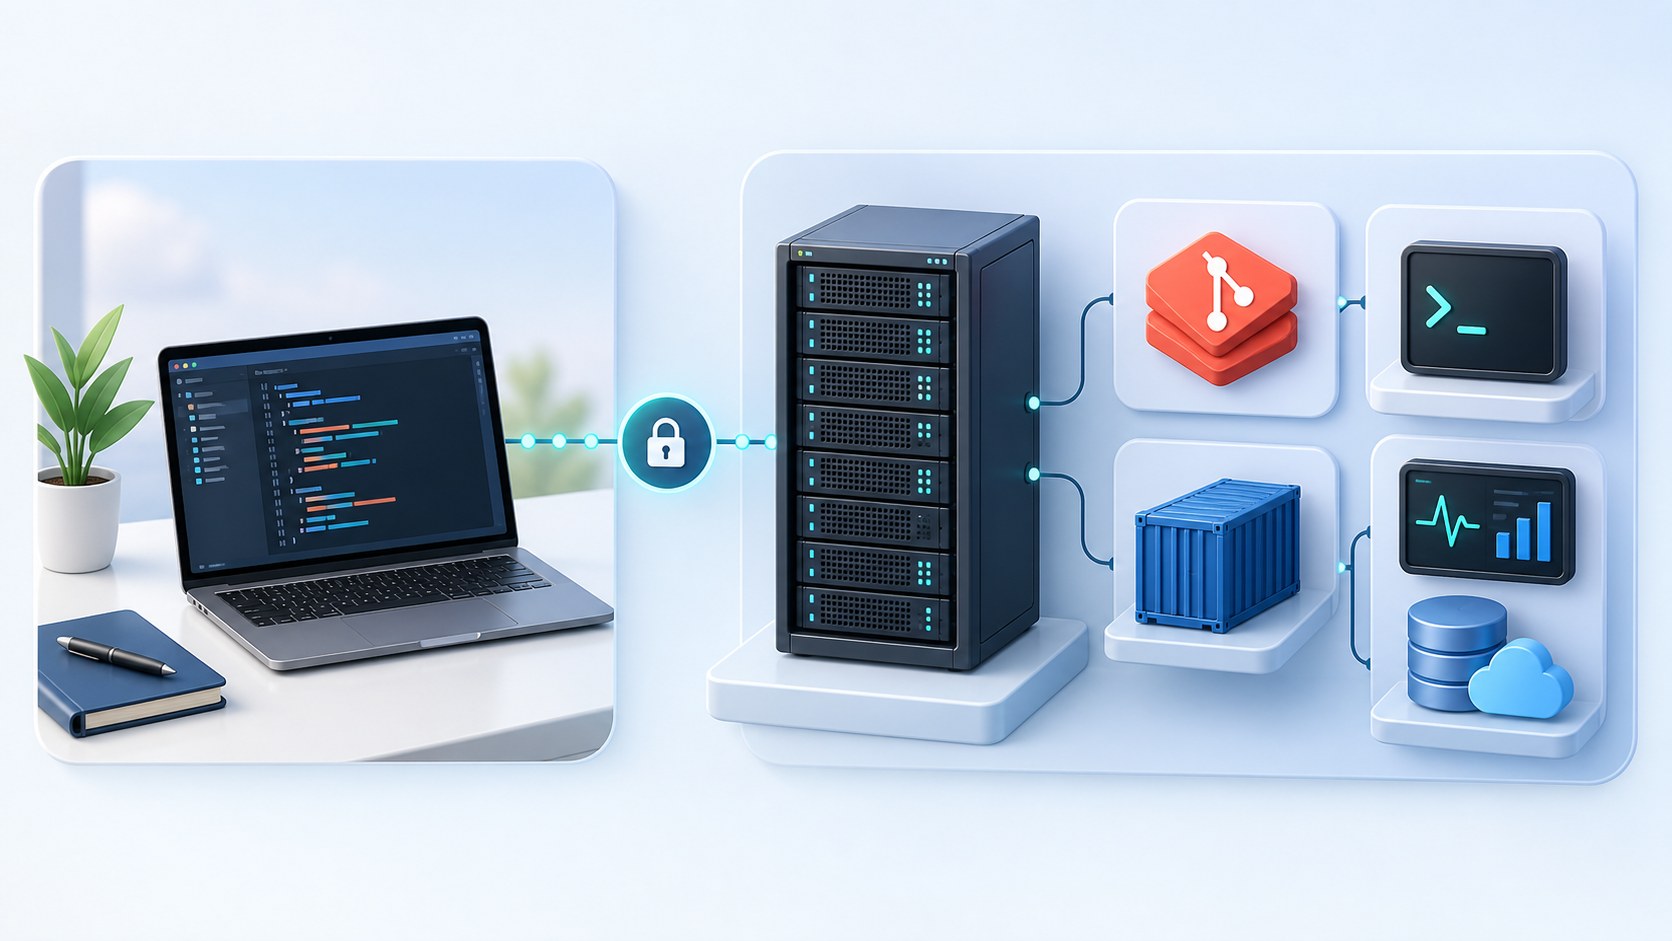
Хостинг для нейросети выбирают по месту выполнения модели. Если приложение обращается к OpenAI, Anthropic или другому внешнему API, на сервере работают только код, очередь и база - GPU не нужен. Для локального запуска модели через Ollama или собственный inference нужен сервер с подходящей видеопамятью либо большой RAM.
Обычный виртуальный хостинг для этой задачи почти всегда тесен: он запрещает постоянные процессы, Docker и системные пакеты. Практичный старт - VPS с Linux, а для локальной модели - отдельный GPU-сервер.
Сначала определите, где работает модель
Есть три разных сценария. API-приложение отправляет запрос внешней модели и получает ответ. AI-агент дополнительно запускает инструменты, хранит состояние и выполняет фоновые задания. Локальная модель загружается на ваш сервер и расходует его RAM или VRAM. Эти варианты нельзя сравнивать одной строкой «сервер для ИИ».
Для API-сценария важнее стабильная сеть, хранение секретов, очередь повторных запросов и лимиты провайдера модели. Для локального inference главный вопрос другой: помещаются ли веса модели и контекст в память ускорителя.
Когда достаточно обычного VPS
VPS с 2 vCPU и 4 ГБ RAM подходит как стартовая среда для небольшого API, Telegram-бота или одного coding-agent процесса. Это ориентир, а не универсальная норма. Сборка большого проекта, браузерная автоматизация и несколько параллельных workers потребуют больше памяти.
На сервере нужны SSH-ключи, firewall, автоматические обновления безопасности, журнал ошибок и перезапуск процесса через systemd, Docker Compose или другой менеджер. Секреты не кладут в Git и не печатают в открытые логи.
Когда нужен GPU-сервер
GPU нужен для обучения, дообучения и быстрого локального inference. Тип ускорителя важнее общего слова «GPU»: Ollama публикует отдельный список поддерживаемых NVIDIA и AMD-моделей. Перед арендой сверьте compute capability, драйвер, объем VRAM и возможность установить нужную версию CUDA или ROCm.
Если модель не помещается в одну видеокарту, она может распределяться между несколькими GPU, но это меняет цену и задержку. CPU-запуск годится для теста небольших моделей, не для обещания быстрой работы сервиса под нагрузкой.
Как оценить память и диск
Сначала выберите модель, квантование, длину контекста и число параллельных запросов. Ollama предупреждает: память растет вместе с параллельностью и контекстом. К весам добавьте место под кеш, контейнеры, логи и резервные копии. Диск на 40 ГБ быстро закончится, если хранить несколько образов и моделей.
Измерьте p95 времени ответа, очередь и пиковую память на реальном наборе запросов. Средняя загрузка CPU не покажет редкие, но длинные задержки.
Какие провайдеры сравнить
| Провайдер | Что проверять | Модель оплаты | Подходящий сценарий |
|---|---|---|---|
 Cloud.ru | Тип GPU, VRAM и квоту | Почасово, ресурсы отдельно | Локальный inference и ML |
| GPU, зону и стоимость диска | Почасово, сеть отдельно | Обучение и облачные данные | |
| Доступный ускоритель и образ | Почасово, ресурсы отдельно | Российская облачная среда | |
| Регион, GPU и исходящий трафик | Почасово с месячным расчетом | Международный inference |
Наличие GPU и квота меняются. До заказа проверьте точную модель ускорителя, VRAM, регион, диск и исходящий трафик.
Официальные источники: Cloud.ru, Yandex Cloud, VK Cloud, Vultr. Проверено 4 сентября 2026 года.
Для API-приложения подойдут обычные VDS: HostVDS, FirstVDS, Timeweb Cloud и Selectel. Для GPU смотрите облака, которые публикуют тип ускорителя и почасовую цену: Cloud.ru, Yandex Cloud, VK Cloud и Vultr.
Дешевый CPU-VPS HostVDS подходит для API-обвязки или агента, но в обычной линейке на витрине нет GPU. Подмена этих сценариев создаст ложную экономию.
Как проверить сервер до оплаты
Разверните копию приложения, включите лимит расходов внешнего API и прогоните типичный пакет запросов. Проверьте перезапуск после reboot, восстановление базы, ротацию логов и поведение при недоступности модели. GPU арендуйте почасово для теста, затем сравните счет за вычисления, диск и исходящий трафик.
Связанные сценарии
Для терминальной разработки смотрите VPS для Codex и Claude Code. Постоянные процессы и инструменты разобраны на странице хостинга AI-агента. Локальная модель вынесена в отдельный материал об Ollama, а визуальные workflow без собственного кода - в руководстве по n8n.